





به گزارش از وبسایت cncf 😊 یک AI factory فقط یک model یا یک cluster نیست؛ بلکه مجموعهای از GPUهاست که چندین تیم همزمان از آن استفاده میکنند: یک تیم در حال fine-tuning، تیمی دیگر مشغول inference و گروهی هم در حال اجرای evaluation، همه روی همان accelerators. NVIDIA این مفهوم را «زیرساختی برای کل چرخه عمر AI، از آمادهسازی داده تا training، fine-tuning و high-volume inference» توصیف میکند. در فضای enterprise، این یعنی یک fleet مشترک، چند تیم مختلف و لایههایی از quota، policy و trust boundary که روی هم قرار میگیرند. پرسش اصلی دیگر این نیست که یک model را چطور train کنیم؛ مسئله این است که چگونه به هر تیم، دسترسی امن و جداگانه به همان سختافزار گرانقیمت بدهیم، بدون اینکه تیمی مزاحم تیم دیگر شود. 🚀
دو سال پیش، تقریباً هر platform team در حال ساخت developer platform بود. Kubernetes از قبل primitiveهای成熟ی برای containers، RBAC، autoscaling و policy داشت. اما چیزی که نداشت، پاسخ روشن برای accelerators و جدا نگهداشتن tenants روی یک node مشترک بود. همین شکاف، همان چیزی است که یک AI factory باید پر کند؛ و حالا ecosystem متنباز cloud native بیشتر قطعات لازم برای پر کردن آن را فراهم کرده است. ⚙️
گلوگاه اصلی، utilization است نه model serving. accelerators بزرگترین هزینه سرمایهای این زیرساخت هستند و معیاری که مشخص میکند این هزینه واقعاً بازده دارد یا نه، peak throughput یک اجرای منفرد نیست، بلکه utilization است. بازار هم GPU cloudها را با همین نگاه ارزیابی میکند. SemiAnalysis در ClusterMAX ارائهدهندگان را بر اساس security، networking، storage، reliability و support میسنجد، نه صرفاً raw throughput؛ و در معیارهای امنیتی، isolation سختگیرانه برای هر tenant را امتیاز مثبت میداند، حتی تا سطح per-tenant Kubernetes cluster و DPU-based isolation، در حالی که مرزهای ضعیف مثل قرار دادن چند tenant روی یک cluster را علامت هشدار تلقی میکند. در واقع، چیزی که ارزیابی میشود همان لایهای است که دور GPUها پیچیده شده است. 💡
دو عامل باعث پایین ماندن utilization میشوند. نخست، مدل منابع: در الگوی سنتی device-plugin، یک pod با درخواست nvidia.com/gpu: 1 کل accelerator را برای خود pin میکند، حتی اگر تنها ۱۰ درصد آن را استفاده کند. Dynamic Resource Allocation (DRA) که در Kubernetes 1.34 به حالت GA رسیده، به scheduler اجازه میدهد accelerators را بهعنوان deviceهایی غنی با ویژگیها، memory و topology ببیند؛ هرچند DRA بهتنهایی GPU را به بخشهای کوچک تقسیم نمیکند و این تراکم از لایه device زیرین میآید. دوم، مدل isolation: برای جدا نگهداشتن تیمها، platformها معمولاً به سراغ cluster اختصاصی یا مجموعه GPU اختصاصی برای هر تیم میروند؛ راهکاری امن در شرایط trust سختگیرانه، اما همراه با اتلاف زیاد سختافزار. همین الگو در عمل هم دیده میشود: operatorهایی که tenants را با bare metal provisioner و workaroundهای دستی مدیریت میکنند، یا برای هر customer یک بلوک اختصاصی از GPU میدهند و تقاضایی را که نتوانند تمیز isolate کنند، رد میکنند. راهحل، یک model server جدید نیست؛ بلکه stackی است که accelerators را طوری allocate کند که ظرفیت هدر نرود و همزمان unsafe هم نباشد، و tenants را طوری جدا کند که کنار هم قرار گرفتنشان قابل اتکا بماند. 🛡️
این stack لایهلایه ساخته میشود. یک AI factory در اصل مسئلهای از جنس assembly است. بیشتر لایهها یا native به Kubernetes هستند یا پروژههای CNCF؛ در کنار آنها چند ابزار OSS مثل NVIDIA’s MIG، vCluster و Dynamo هم دیده میشوند. جدول زیر، نقش هر لایه را نشان میدهد. 📋
Hardware lifecycle: provisioning و validation روی bare metal با Metal3 / Ironic، Tinkerbell، Redfish و NetBox
Cluster lifecycle: ایجاد، versioning و GitOps برای clusterها با Cluster API، Argo CD یا Flux، NVIDIA AICR
Node inventory: برچسبگذاری GPU، NIC، MIG و topology با Node Feature Discovery و GPU & Network Operator (NVIDIA, AMD)
Tenant isolation: جدا نگهداشتن تیمها روی یک hardware مشترک با tenant clusterها (vCluster) و sandboxed runtimeها
GPU allocation: تخصیص و زمانبندی accelerators با DRA، MIG، HAMi، time-slicing؛ همچنین KAI Scheduler (Topology Aware Scheduling)، Volcano و Kueue
Inference and serving: اجرای modelها پشت API با vLLM، KServe، llm-d
Batch and HPC: اجرای workloadهای SLURM با Slinky (SLURM on Kubernetes)
VMs: اجرای virtual machine برای tenants با KubeVirt
Gateway and autoscaling: مسیریابی و scale کردن endpointها با Gateway API، Envoy، LiteLLM، KEDA و HPA
Networking: جابهجایی data بین GPUها و جداسازی tenants با Cilium، Multus، SR-IOV، RDMA based networking solution
Storage and data: نگهداری datasetها، checkpointها و modelها با CSI، Rook / Ceph، parallel filesystem CSI و object storage
Observability: مشاهده utilization، log و trace با Prometheus، OpenTelemetry و DCGM exporter
Identity and policy: احراز هویت، authorization، quota و guardrail با Keycloak (OIDC)، ResourceQuota / Kueue، Kyverno یا OPA
Secrets and security: مدیریت secrets، runtime و supply chain با OpenBao + External Secrets، Falco و Trivy
Reliability and remediation: تشخیص و بازیابی از node failure با DCGM health checks، Node Problem Detector، drain / cordon
Self-service and billing: provision و charge کردن tenants با API / OpenTofu / GitOps، OpenCost و DCGM GPU-seconds
از bare metal تا capacity تاییدشده همهچیز از rack شروع میشود. یک مثال رایج در platformهای مدرن AI و supercomputing این است که پیش از اجرای هر workload روی GPU، باید سرورهای خام به یک pool قابل استفاده تبدیل شوند. این همان provisioning layer است؛ معمولاً یک hardware manager اختصاصی که همراه سیستم ارائه میشود. روند کار چند مرحله دارد. ابتدا هر node شناسایی و inventory میشود: اینکه چند GPU دارد، آیا memory سالم است یا نه (ECC state، یعنی error-correction فعال است و خطا ثبت نشده)، و شناسههای کارت شبکه چیستند (InfiniBand GUIDs و NIC MACs، شناسههای سختافزاری دائمی برای کابلکشی و boot node). سپس node از طریق شبکه boot میشود و یک OS image همراه با GPU driver و کتابخانههای CUDA و NCCL روی آن نصب میگردد تا به محض بالا آمدن، آماده compute باشد. بعد BIOS settings متناسب با هدف node اعمال میشود: baseline، performance یا confidential-compute. پیش از آنکه node وارد pool شود، تحت آزمایش قرار میگیرد. این burn-in، node را زیر بار میبرد تا خرابیهای زودهنگام آشکار شوند و یک NCCL test هم بررسی میکند که GPUها واقعاً با پهنای باند کامل با هم ارتباط دارند یا نه. نتیجه در یک source of truth مثل NetBox ثبت میشود که IP address assignmentها (IPAM) را هم نگه میدارد. بازنشسته کردن یک node، همین مسیر را برعکس طی میکند: پاک کردن diskها، reset کردن login مدیریت از راه دور مثل BMC، و بازگرداندن node تمیز به pool. این hardware manager اختصاصی، نسخه vendor از همین لایه است که بهطور عمیق با سیستمهای خودش گره خورده؛ مسیر دیگر این است که همان چرخه را از building blockهای متنباز کنار هم بسازید: Metal3 همراه Ironic، یا راهکاری مانند vMetal، تا discovery، image، validation و reclaim را با شرایط خودتان داشته باشید، نه با پذیرش کامل stack فروشنده. این همان انتخاب build-versus-assemble است؛ انتخابی که در تمام لایههای بعدی هم تکرار میشود. 🧩
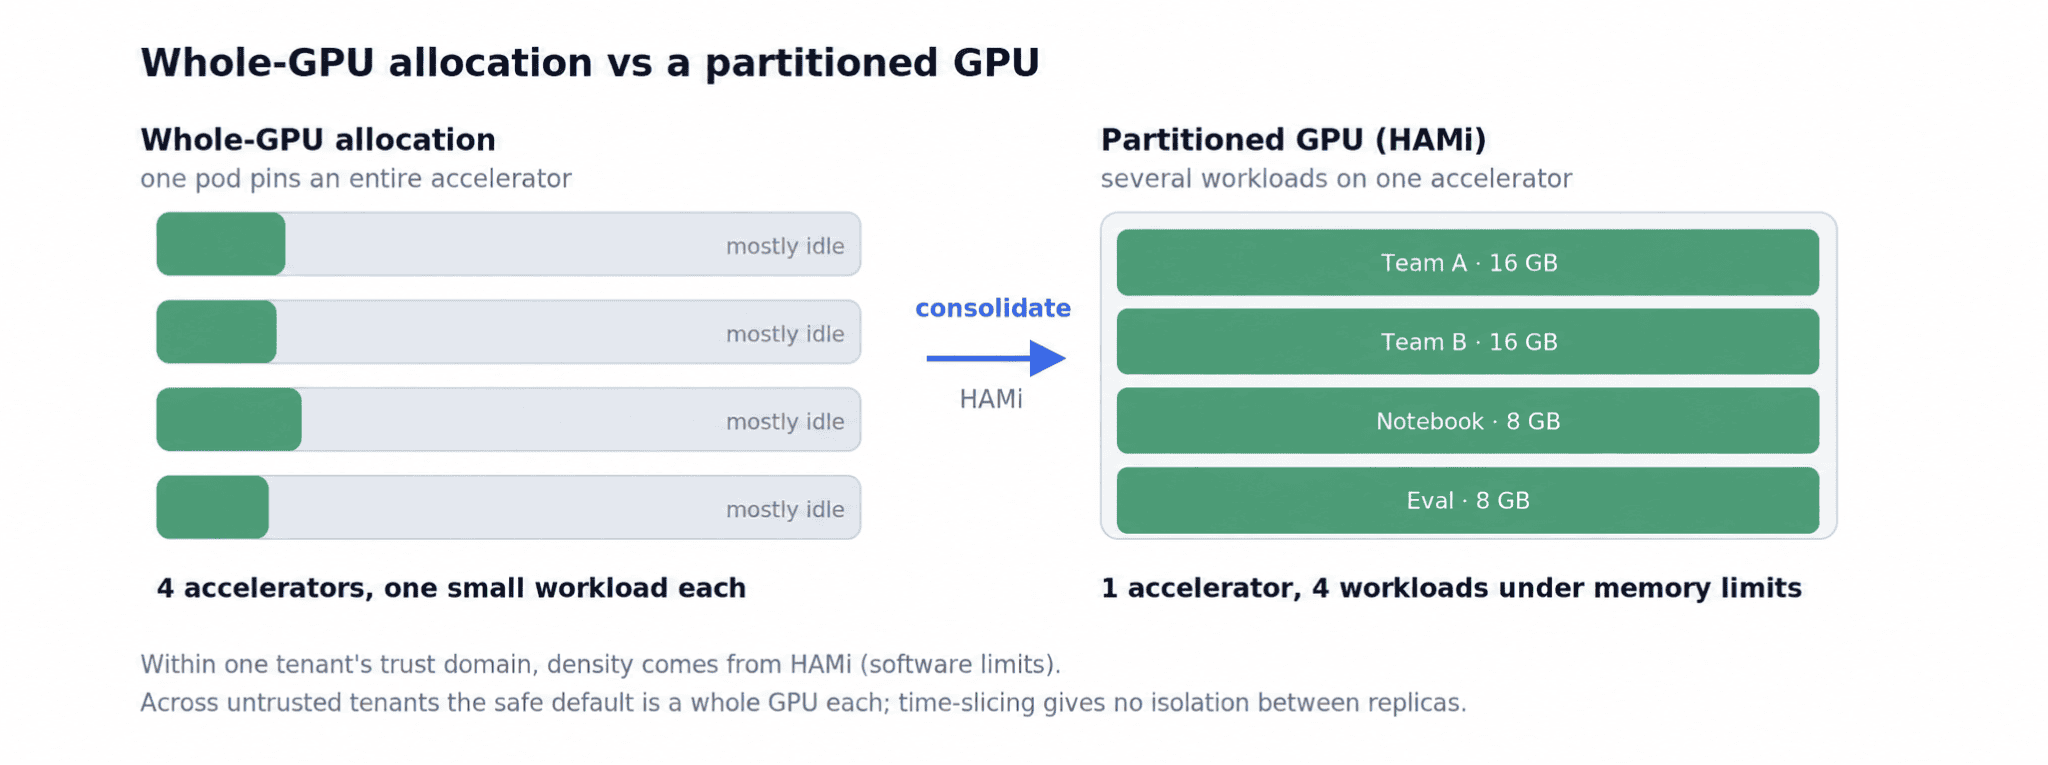
GPU allocation: لایهای که اقتصاد را به صرفه میکند. Figure 1. تخصیص whole-GPU در برابر GPU partitioned. DRA مدل richer برای device-claim ارائه میدهد، اما density جزئی از implementation خود device میآید. HAMi، یک پروژه CNCF Incubating، با enforce کردن memory و compute limitها در software اجازه میدهد چند pod روی یک card اجرا شوند، البته با guardrail میان آنها، و از چند vendor accelerator پشتیبانی میکند. اپراتورهایی که به سمت confidential computing میروند، tenantهای غیرقابلاعتماد را روی یک physical GPU مشترک قرار نمیدهند؛ آنها به هر tenant یک GPU کامل میدهند و partitioning را برای workloadهای داخل یک trust domain واحد نگه میدارند. MIG از نظر hardware، memory و faultها را جدا میکند، اما استفاده از آن بهعنوان مرز بین tenantهای خصمانه محل بحث است؛ بنابراین پیشفرض محتاطانه، whole-GPU برای هر tenant است. این لایه دو وظیفه دارد: تخصیص whole-GPU برای isolation tenantها، و partitioning برای density داخل یک tenant. scheduling موضوعی جداست: KAI Scheduler و Volcano جابهجایی gang و topology-aware را مدیریت میکنند و Kueue وظیفه queueing، admission و quota را بر عهده دارد. 🔧
لایههای workload: serving، Slurm و VMها. بالای allocation، چیزهایی قرار دارند که تیمها واقعاً اجرا میکنند. برای inference، vLLM یک engine رایج است و KServe، یک پروژه CNCF incubating، آن را با autoscaling و endpointهای استاندارد بستهبندی میکند؛ در حالی که NVIDIA Dynamo و llm-d برای استقرارهای بزرگتر، disaggregated inference را جلو میبرند. در لایه جلویی، Gateway API routing را بر عهده دارد و LiteLLM یک gateway سازگار با OpenAI اضافه میکند تا دهها model تخصصی از یک API واحد استفاده کنند. مشتریان training معمولاً در Slurm زندگی میکنند و این الگو به اجرای Slurm روی Kubernetes از طریق SchedMD’s Slinky رسیده است؛ جایی که daemonهای Slurm بهصورت CRD نمایش داده میشوند و با GPU Operator و DRA برای topology-aware scheduling یکپارچه میشوند، همراه با pyxis و enroot، GPUDirect RDMA با پهنای باند کامل NCCL، و health checkهای prolog و epilog. برخی tenantها هم بهجای pod، virtual machine معمولی میخواهند؛ KubeVirt VMها را بهعنوان workloadهای Kubernetes اجرا میکند، بنابراین یک platform میتواند container و VM را از همان fleet مشترک، تحت همان RBAC و quota، در اختیار بگذارد. 🖥️
Networking، storage و observability. training و disaggregated inference به پهنای باند وابستهاند، پس network بخشی از طراحی است. Cilium بهعنوان primary CNI و برای network policy عمل میکند؛ برای fast path، Multus و SR-IOV NIC را مستقیم در اختیار میگذارند و RDMA روی RoCEv2 یا InfiniBand ترافیک GPU بین nodeها را حمل میکند، در حالی که isolation layer از آن data path دور نگه داشته میشود. یک cloud واقعی همچنین serviceهای edge-like مورد انتظار tenantها را فراهم میکند: elastic IP، NAT و L4 load balancing از طریق gatewayی در جلوی fabric. storage هم به persistence اختصاصی برای هر tenant نیاز دارد، معمولاً با CSI بههمراه Rook و Ceph یا یک parallel filesystem، تحت مدیریت StorageClass و quotaهای اختصاصی. برای observability، OpenTelemetry لایه جمعآوری بیطرف است که backendها را قابل تعویض نگه میدارد، Prometheus برای metrics و VictoriaLogs برای logها بهکار میروند؛ DCGM exporter telemetry مربوط به GPU را منتشر میکند که فقط با labelها و یک cost pipeline به دادهای per-tenant تبدیل میشود، و OpenCost هم GPU-seconds را به chargeback تبدیل میکند. 📈
Reliability و security. در مقیاس fleet، GPUها مدام خراب میشوند: ECC errorها، کارتهایی که از bus میافتند، و NVLink یا thermal faultها. وظیفه operator این است که این مشکلات را پیش از رسیدن به tenant شناسایی کند؛ به همین دلیل، health یک لایه اصلی است نه یک dashboard فرعی. بررسیهای active و passive روی DCGM، نشانههای degradation را رصد میکنند، Node Problem Detector سیگنالهای سختافزاری را به node condition تبدیل میکند، و یک remediation loop node مشکوک را cordon و drain میکند تا کار جدیدی روی آن وارد نشود. این یکی از دستههایی است که سیستمهای رتبهبندی بیشترین توجه را به آن دارند، چون reliability، نه peak throughput، معیار واقعی اعتماد است. ✅




