





به گزارش از وبسایت cncf 📌
در تاریخ ۲۸ اوت ۲۰۲۶، رامکومار ناگاراج و بینگی ناراسیما کارتیک، هر دو از Adobe و با عنوان Golden Kubestronaut، این مطلب را منتشر کردند.
🕒 تماس ساعت ۳ صبح
یک سهشنبه صبح زود، هشدار فوری دریافت کردیم. یکی از سرویسهای حیاتی در محیط production زیر فشار ترافیک از کار افتاده بود؛ نه اینکه فقط کند شده باشد، بلکه کاملاً crash کرده بود. صدها pod در صف انتظار مانده بودند و کاربران با نرخ خطای ۱۵ تا ۲۰ درصد روبهرو بودند.
گزارش پس از حادثه بسیار سختگیرانه بود: autoscaling واکنشی فعال شده بود، اما خیلی دیر.
روند اتفاقها اینطور بود:
06:00 – جهش ترافیک آغاز شد
06:05 – آستانه HPA رد شد و replicaهای Deployment افزایش یافتند
06:15 – podهای جدید شروع به scheduling کردند
06:45 – نخستین GPU nodeها provision شدند و podها واقعاً شروع به اجرا کردند
تا ساعت 06:45، موج ترافیک تمام شده بود. مشتریان پیشتر با خطا مواجه شده بودند. سیستم تلاش کرده بود scale شود، اما محدودیتهای زیرساخت اجازه نمیدادند بهموقع پاسخ بدهد.
ریشه مشکل یک bug نبود؛ ناهماهنگی میان نیاز workload و سرعت provisioning بود.
scale کردن سرویسهای فقط CPU معمولاً چند دقیقه طول میکشد. اما scale کردن GPU nodeها ۳ تا ۵ برابر بیشتر زمان میبرد: firmware بارگذاری میشود، driverها initialize میشوند و CUDA آماده میشود.
HPA واکنشی، ذاتاً منتظر میماند تا تقاضا ظاهر شود و بعد ظرفیت سفارش میدهد. برای workloadهای GPU، این یعنی واکنش از نوعی که بدترین زمانبندی ممکن را دارد.
آن شب به این نتیجه رسیدیم که باید جهش ترافیک را قبل از رسیدن آن ببینیم. 🔍
بینش اصلی: پیشبینی همهچیز را تغییر میدهد
ما از قبل همه دادههای لازم را داشتیم؛ Prometheus بهطور مداوم CPU، memory، latency، RPS و میزان استفاده از NVIDIA GPU را جمعآوری میکرد. یک هفته داده تاریخی هم در storage موجود بود.
سؤال این نبود که آیا میتوانیم تقاضا را پیشبینی کنیم یا نه؛ سؤال این بود که آیا میتوانیم آن را به اندازهای دقیق پیشبینی کنیم که واقعاً ارزش داشته باشد.
یک فرضیه را امتحان کردیم: اگر یک Kubernetes controller که هر ۶۰ ثانیه اجرا میشود، بتواند یک ساعت گذشته از metrics را بررسی کند و تقاضا را ۱۰ دقیقه جلوتر پیشبینی کند، چه میشود؟
نه دقیقِ کامل؛ فقط بهاندازهای خوب که ظرفیت لازم پیشاپیش provision شود و وقتی ترافیک واقعاً رسید، آماده باشد.
ایده ساده بود. اجرای آن اما… جالبتر از چیزی بود که انتظار داشتیم.
ساخت controller پیشبین
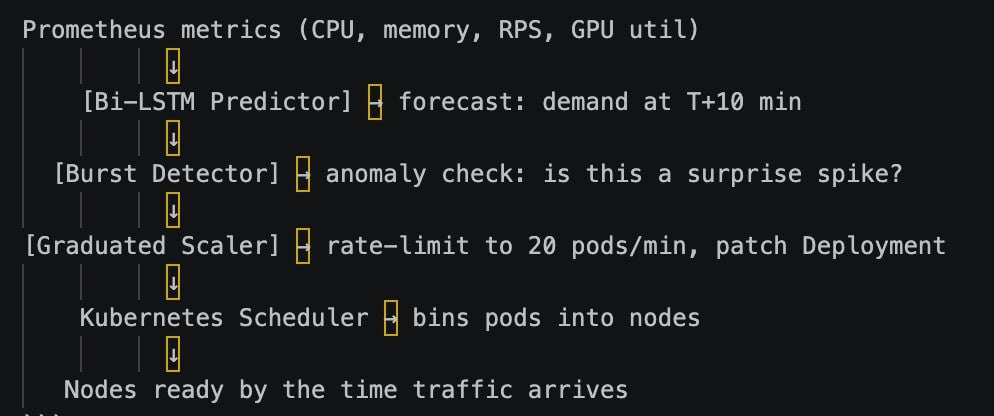
ما به یک معماری سهبخشی رسیدیم: Predict، Provision، Absorb.
نحوه کار این اجزا به این شکل است:
controller هر ۶۰ ثانیه اجرا میشود، دادههای یک ساعت گذشته را دریافت میکند، inference را از طریق model آموزشدیده انجام میدهد، بررسی میکند که آیا burst در حال رخ دادن است یا نه، و سپس بهتدریج scale up میکند. وقتی تقاضا ۱۰ دقیقه بعد واقعاً برسد، ظرفیت از قبل warm شده و آماده است.
بخش ۱: Predictor (Bi-LSTM)
چند گزینه را بررسی کردیم:
ARIMA و exponential smoothing: سریع و قابلتفسیر، اما در مواجهه با burstهای ناگهانی و plateauها ضعیف بودند.
Prophet (کتابخانه Prophet متعلق به Meta): برای تشخیص seasonality بهتر بود، اما برای افق ۱۰ دقیقهای ما بیش از حد پیچیده محسوب میشد.
LSTM: از نظر معماری فراتر از نیاز بود، اما زیرساخت training TensorFlow داشتیم و ۵۰ epoch داده استفاده GPU در اختیارمان بود؛ یعنی ۱۰,۰۸۰ sample برای یادگیری.
در نهایت Bi-LSTM را انتخاب کردیم؛ یک LSTM دو لایه با ۶۴ unit و سپس ۳۲ unit که دنباله را هم از عقب و هم از جلو میبیند.
چرا؟ چون الگوهایی دیده بودیم که فقط روند خطی نبودند. استفاده از GPU شامل micro-burstها، valleyهای بازیابی و plateauهای غیرعادی بود. Bi-LSTM این الگوها را بهتر از روشهای سادهتر مدیریت میکرد.
از نظر تئوری شاید «انتخاب درست» نبود، اما برای دادههای ما انتخاب مناسبتری بود.
model درون controller اجرا میشود. ما آن را هر هفته با دادههای جدید retrain میکنیم، اما model مستقر فقط inference انجام میدهد؛ نه ML platform خارجی داریم و نه لایه model serving. فقط TensorFlow Lite است که داخل یک Go controller binary قرار گرفته است.
مبادلهها روشن بودند: دقت بهتر، با هزینه زمان training بیشتر و تفسیر سختتر. ما نمیتوانستیم دقیقاً توضیح دهیم چرا model یک مقدار خاص تقاضا را پیشبینی کرده، همانطور که در ARIMA ممکن بود. اما برای autoscaling، کافی بود ۸۰ درصد مواقع درست باشیم، نه ۱۰۰ درصد.
بخش ۲: Burst Detection (Anomaly Catcher)
model بر اساس الگوهای آموختهشده پیشبینی میکند، اما anomalyها همیشه رخ میدهند. یک کمپین بازاریابی شروع میشود. یک feature viral میشود. الگوی ترافیک به شکلی تغییر میکند که دادههای training آن را پوشش ندادهاند.
برای همین یک burst detector را بهصورت موازی اضافه کردیم. این بخش یک threshold تطبیقی را بر اساس rolling standard deviation بین پیشبینیهای اخیر و مقدار واقعی حفظ میکند.
اگر تقاضای واقعی ناگهان از پیشبینی با فاصلهای بیشتر از confidence interval عبور کند، burst detector فعال میشود و agresiveness در scale-out را افزایش میدهد.
این یک model دوم نیست؛ یک safety net مبتنی بر heuristic است. وقتی فعال میشود، این پیام را میدهد: «model شما نمیداند چه چیزی در راه است. سریعتر scale کنید.» ⚠️
بخش ۳: Graduated Scaler (پایداری)
اینجا بود که یک درس مهم گرفتیم: اگر به Kubernetes بگویید در هر ثانیه ۱۰۰ pod scale کند، دقیقاً متوجه میشوید cluster شما در هر ثانیه چند چرخه scheduler را میتواند تحمل کند. و جواب؟ زیاد نیست.
graduated scaler نرخ scale را به ۲۰ pod در دقیقه محدود میکند.
این شاید کند به نظر برسد، اما در عمل بسیار مناسب است:
nodeها فرصت پیدا میکنند قبل از صف بعدی پایدار شوند.
etcd از هزاران update برای Deployment دچار thrash نمیشود.
kubelet واقعاً میتواند containerها را pull و start کند، نه اینکه آنها را برای همیشه در صف نگه دارد.
init containerها و sidecar injection مربوط به service mesh قبل از رسیدن batch بعدی تکمیل میشوند.
هدف utilization برابر ۷۰ درصد است، نه ۱۰۰ درصد. این کار هم headroom لازم برای جهش واقعی را فراهم میکند و هم به predictor زمان میدهد تا اگر اشتباه کرد، باعث زنجیرهای شدن failureها نشود.
منطق کار در pseudo-code چنین است:
نکته کلیدی این است که graduated scaling از مشکل thundering herd جلوگیری میکند؛ جایی که ۱۰۰۰ pod همزمان برای scheduling، pull کردن image، initialize کردن sidecarها و query زدن به etcd هجوم میآورند.
با آزادسازی آنها در موجهای ۲۰تایی در دقیقه، هر موج فرصت میکند پیش از رسیدن موج بعدی کامل شود.
اعتبارسنجی: ۲۳ از ۲۳ بررسی موفق
ابتدا در shadow mode استقرار دادیم؛ پیشبینیها اجرا میشدند اما هیچ چیزی scale نمیشد. بیش از ۵۰۰ ساعت داده shadow جمعآوری کردیم و این موارد را سنجیدیم:
دقت پیشبینی: ۸۵ درصد در محدوده ±۱۰ درصد تقاضای واقعی در T+10min
دقت burst detection: شناسایی ۹ مورد از ۱۰ جهش واقعی، با ۲ false positive که قابلقبول بود
پایداری graduated scaling: بدون cascading failure و بدون oscillation
همزیستی با HPA v2: بدون conflict در کنار HPA واکنشی اجرا شد
این طراحی برای production آماده بود و دو guardrail حیاتی داشت:
حداکثر replica cap، یعنی controller نمیتواند از آن فراتر برود
runbook برای غیرفعالسازی در صورتی که پیشبینیها از واقعیت فاصله بگیرند
در طول اعتبارسنجی hackathon یکهفتهای در یک محیط dev کنترلشده:
۲۳ مورد از ۲۳ بررسی اعتبارسنجی با موفقیت گذشت.
هیچ cascading failure و هیچ oscillationی رخ نداد.
ما الگوهای جهشی مشابه را در تست شبیهسازی کردیم و predictor آنها را ۱۱ دقیقه زودتر و با دقت مناسب شناسایی کرد؛ این نتیجه تأیید میکند که این رویکرد میتوانست از حادثه اولیه جلوگیری کند. ✅
اگر دوباره انجام میدادیم، چه چیزهایی را تغییر میدادیم؟
پیچیدگی model: کار را با Bi-LSTM شروع کردیم چون زیرساختش را داشتیم. صادقانه بگوییم؟ احتمالاً یک ARIMA خوب تنظیمشده، با ۱۰ درصد از زیرساخت، به ۸۰ درصد نتیجه میرسد. باید بیشتر روی روشهای سادهتر benchmark میکردیم.
Retraining: ما هر هفته retrain میکنیم، اما باید پس از هر incident مهم این کار را انجام دهیم. وقتی الگوهای ترافیک تغییر میکنند، مثل زمان عرضه یک feature جدید یا فعالیت رقبا، model ظرف چند روز قدیمی میشود.
Explainability: اینکه «چرا predictor عدد ۱۵۰ pod را پیشبینی کرد؟» پرسشی بود که پاسخ خوبی برایش نداشتیم. برای operatorها این موضوع آزاردهنده است. یک رویکرد ترکیبی—LSTM برای پیشبینی و SHAP برای توضیح عوامل مؤثر—احتمالاً ارزش پیچیدگی بیشتر را داشت.
rollout تدریجی: ما از shadow به production در دو مرحله رفتیم. با نگاه به گذشته، سه مرحله بهتر بود: shadow، سپس capped scale با حداکثر ۱۰ pod در هر چرخه پیشبینی، و بعد scale کامل. اگر مشکلی پیش میآمد، blast radius کوچکتر میشد.
رویکرد CNCF-Native
ما این راهکار را بدون extensionهای proprietary ساختیم:
بدون CRD. controller replicaهای Deployment را مستقیم patch میکند، درست مثل HPA.
بدون ML platform. TensorFlow داخل binary خود controller اجرا میشود.
بدون model server و بدون external inference API.
telemetry استاندارد. Prometheus، Thanos در صورت استقرار، و GPU metrics exporterهایی مانند NVIDIA DCGM.
همکاری با HPA v2. با آن رقابت نمیکند و جایگزینش نمیشود؛ بلکه آن را تکمیل میکند.
این مهم است، چون یعنی میتوانید آن را روی هر Kubernetes cluster که از قبل Prometheus دارد اجرا کنید. نه زیرساخت جدید لازم است، نه vendor جدید. فقط یک controller و یک model artifact آموزشدیده کافی است.
چه زمانی این روش مهم است و چه زمانی نه
predictive scaling در این شرایط میدرخشد:
provisioning کند است. GPU nodeها، bare-metal fleetها، یا هر چیزی که راهاندازی آن بیش از ۲ تا ۳ دقیقه طول میکشد.
ترافیک تا حدی قابل پیشبینی است. الگوهای ساعتی، چرخههای هفتگی، رویدادهای فصلی شناختهشده. (ترافیک کاملاً تصادفی سختتر است.)
telemetry خوبی دارید. Prometheus با حداقل یک هفته history.
پایداری مهمتر از هزینه است. ما عمداً utilization را روی ۷۰ درصد هدف گرفتهایم؛ یعنی برای headroom هزینه میدهیم.
در این موارد بیش از حد لازم است:
اگر nodeهای شما در ۳۰ ثانیه provision میشوند، HPA واکنشی کافی است.
اگر تقاضا واقعاً تصادفی باشد، هیچ Bi-LSTMی کمکی نمیکند.
اگر اولویت اصلی شما کاهش هزینه باشد، predictive scaling nodeهای warm بیشتری نگه میدارد.
پرسشهای باز
از اعتبارسنجی ما در hackathon، چند سؤال برای deployment در production باقی مانده است:
چه مقدار داده کافی است؟ ما از ۵۰ epoch یعنی ۱۰,۰۸۰ sample استفاده کردیم. آیا ۲۰ epoch کافی بود؟ آیا ۱۰۰ epoch دقت را بهتر میکرد؟ هنوز به این پرسشها پاسخ ندادهایم.
آیا میتوان anomalyها را بهتر پیشبینی کرد؟ burst detector ما heuristic است. آیا یک ensemble model مثل LSTM بههمراه isolation forest میتواند black swanهایی را که هر کدام بهتنهایی از دست میدهند، شناسایی کند؟
بهترین cadence برای retraining چیست؟ برای ما هفتگی جواب میدهد، اما برای سرویسهایی با demand نوسانی، شاید daily بهتر باشد.
اگر شما هم به این رویکرد برای workloadهای خود فکر میکنید، خوشحال میشویم ببینیم این پرسشها در زمینه شما چه پاسخی پیدا میکنند. 🤝
شروع کار
اجزای اصلی سادهاند:
یک هفته metrics از Prometheus جمعآوری کنید (CPU، memory، latency، RPS؛ و در صورت نیاز metrics مربوط به GPU)
یک forecasting model آموزش دهید (Bi-LSTM، ARIMA، Prophet — یکی را انتخاب کنید)
یک controller بنویسید که هر ۶۰ ثانیه inference انجام دهد و replicaهای Deployment را patch کند
یک هفته در shadow mode استقرار دهید (پیشبینیها ثبت شوند، اما scale انجام نشود)
دقت را بررسی کنید (هدف: بیش از ۸۰ درصد در محدوده ±۱۰ درصد)
با guardrailها وارد production شوید (حداکثر replica cap و امکان disable)
ما یاد گرفتهایم که معماری model کمتر از اعتبارسنجی مداوم اهمیت دارد. از ساده شروع کنید. اگر ساده جواب داد، همان ساده را منتشر کنید. complexity یک ویژگی محسوب نمیشود. ✨
جمعبندی
حادثهای که این کار را آغاز کرد، یک شکاف واقعی را در زمانبندی پاسخگویی نشان داد…




