





کubernetes v1.36: PSI Metrics برای Kubernetes به مرحله GA رسید 🚀
از زمانی که Pressure Stall Information یا همان PSI برای نخستین بار در سال 2018 وارد Linux kernel شد، این قابلیت به تیمها کمک کرده تا قبل از تبدیل شدن فشار منابع به outage، نشانههای دقیق و قابل اتکایی از saturation را ببینند. تفاوت PSI با metricهای معمول utilization این است که فقط درصد مصرف را نشان نمیدهد؛ بلکه توضیح میدهد چه مقدار از زمان، taskها بهخاطر کمبود CPU، memory یا I/O در حالت stall ماندهاند.
با انتشار Kubernetes v1.36، حالا یک interface پایدار و قابل اعتماد برای مشاهده resource contention در سطح node، pod و container در اختیار کاربران قرار گرفته است. در ادامه، بهبودها و تستهای performanceای را مرور میکنیم که نشان دادند این قابلیت آماده استفاده در production است ✅
نگاهی فراتر از utilization: چرا PSI مهم است؟
فقط نگاه کردن به میزان CPU یا memory usage همیشه تصویر درستی نمیدهد. ممکن است یک node کمتر از 100% CPU utilization داشته باشد، اما بعضی taskها بهخاطر scheduling delay با latency شدید روبهرو شوند. PSI این شکاف را پر میکند و دو نوع داده مهم میدهد:
Cumulative Totals: مجموع زمان واقعی که سیستم در حالت stall بوده است.
Moving Averages: بازههای 10 ثانیه، 60 ثانیه و 300 ثانیه که به operator کمک میکند بین spikeهای کوتاهمدت و فشار پایدار منابع تفاوت بگذارد.
اثبات پایداری: performance testing در مقیاس بالا
یکی از نگرانیهای رایج هنگام GA شدن قابلیتهای telemetry، میزان overhead برای جمعآوری و ارائه metricهاست. برای بررسی این موضوع، SIG Node تستهای گستردهای را روی workloadهای متراکم، با بیش از 80 pod و روی چند نوع machine اجرا کرد.
تستها روی دو سناریوی اصلی متمرکز بودند تا اثر Kubelet و جمعآوری در سطح kernel جداگانه بررسی شود:
Kernel PSI ON / Kubelet Feature OFF در برابر Kernel PSI ON / Kubelet Feature ON برای بررسی overhead مربوط به Kubelet
Kernel PSI OFF / Kubelet Feature ON در برابر Kernel PSI ON / Kubelet Feature ON برای بررسی overhead مربوط به kernel
سناریوی 1: overhead مربوط به Kubelet
در مرحله اول، مصرف Kubelet روی ماشینهای 4 core بررسی شد. در این محیط، Linux kernel از قبل روی هر دو cluster فشار منابع را بهصورت پیشفرض track میکرد (psi=1)، اما KubeletPSI feature gate را تغییر دادند تا مشخص شود آیا query کردن و expose کردن این metricها توسط Kubelet روی resource usage اثر دارد یا نه. burstهای هماهنگی که در نمودار دیده میشوند، از نظر شدت و دفعات تقریباً یکسان هستند و این موضوع نشان میدهد logic جمعآوری در Kubelet بسیار lightweight است و بدون اصطکاک خاصی در چرخه معمول housekeeping اجرا میشود. این قابلیت در حدی کمهزینه است که حدود 0.1 core یا نزدیک به 2.5% از ظرفیت کل node را هم از محدوده امن خارج نمیکند، بنابراین برای deploymentهای production-scale مناسب است 👍
(Case 1) Kubelet CPU Usage Rate Comparison
Figure 2: Kubelet CPU Usage Rate Comparison.
در ادامه، overhead سیستم را هم در همان run بررسی کردند. همانطور که در نمودار دیده میشود، خط System CPU در cluster مجهز به Kubelet PSI (قرمز) تقریباً همان الگوی cluster بدون Kubelet PSI (آبی) را دنبال میکند و فقط یک افزایش خفیف و قابل انتظار نسبت به baseline دیده میشود. این یعنی وقتی OS خودش PSI را track میکند، خواندن این cgroup metricها توسط Kubernetes در حدود 2.5 cores تقریباً اثر قابل توجهی روی performance ندارد.
(Case 1) System CPU Usage Rate Comparison
Figure 1: Node System CPU Usage Rate Comparison.
سناریوی 2: overhead مربوط به kernel
در مرحله بعد، overhead اصلی فعالسازی PSI در Linux kernel روی همان ماشین 4 core ارزیابی شد. با مقایسه clusterای که با psi=1 بوت شده بود (COS default) و clusterای که psi=0 داشت، هزینه دقیق bookkeeping در سطح OS جدا شد. حتی زیر فشار شدید I/O و CPU و در تراکم 80 pod، اختلاف System CPU بین clusterهای دارای kernel PSI و بدون آن، بهطور پایدار بین 0.037 core تا 0.125 core باقی ماند؛ یعنی حدود 0.925% تا 3.125% از ظرفیت کل node. فقط یک spike تا 0.225 core، یعنی 5.6%، ثبت شد که ظرف چند ثانیه دوباره پایین آمد. این نتایج نشان میدهد tracking داخلی kernel حتی زیر بار بالا هم بسیار بهینه عمل میکند.
(Case 2) Node System CPU Usage Rate Comparison
Figure 3: Node System CPU Usage Rate Comparison.
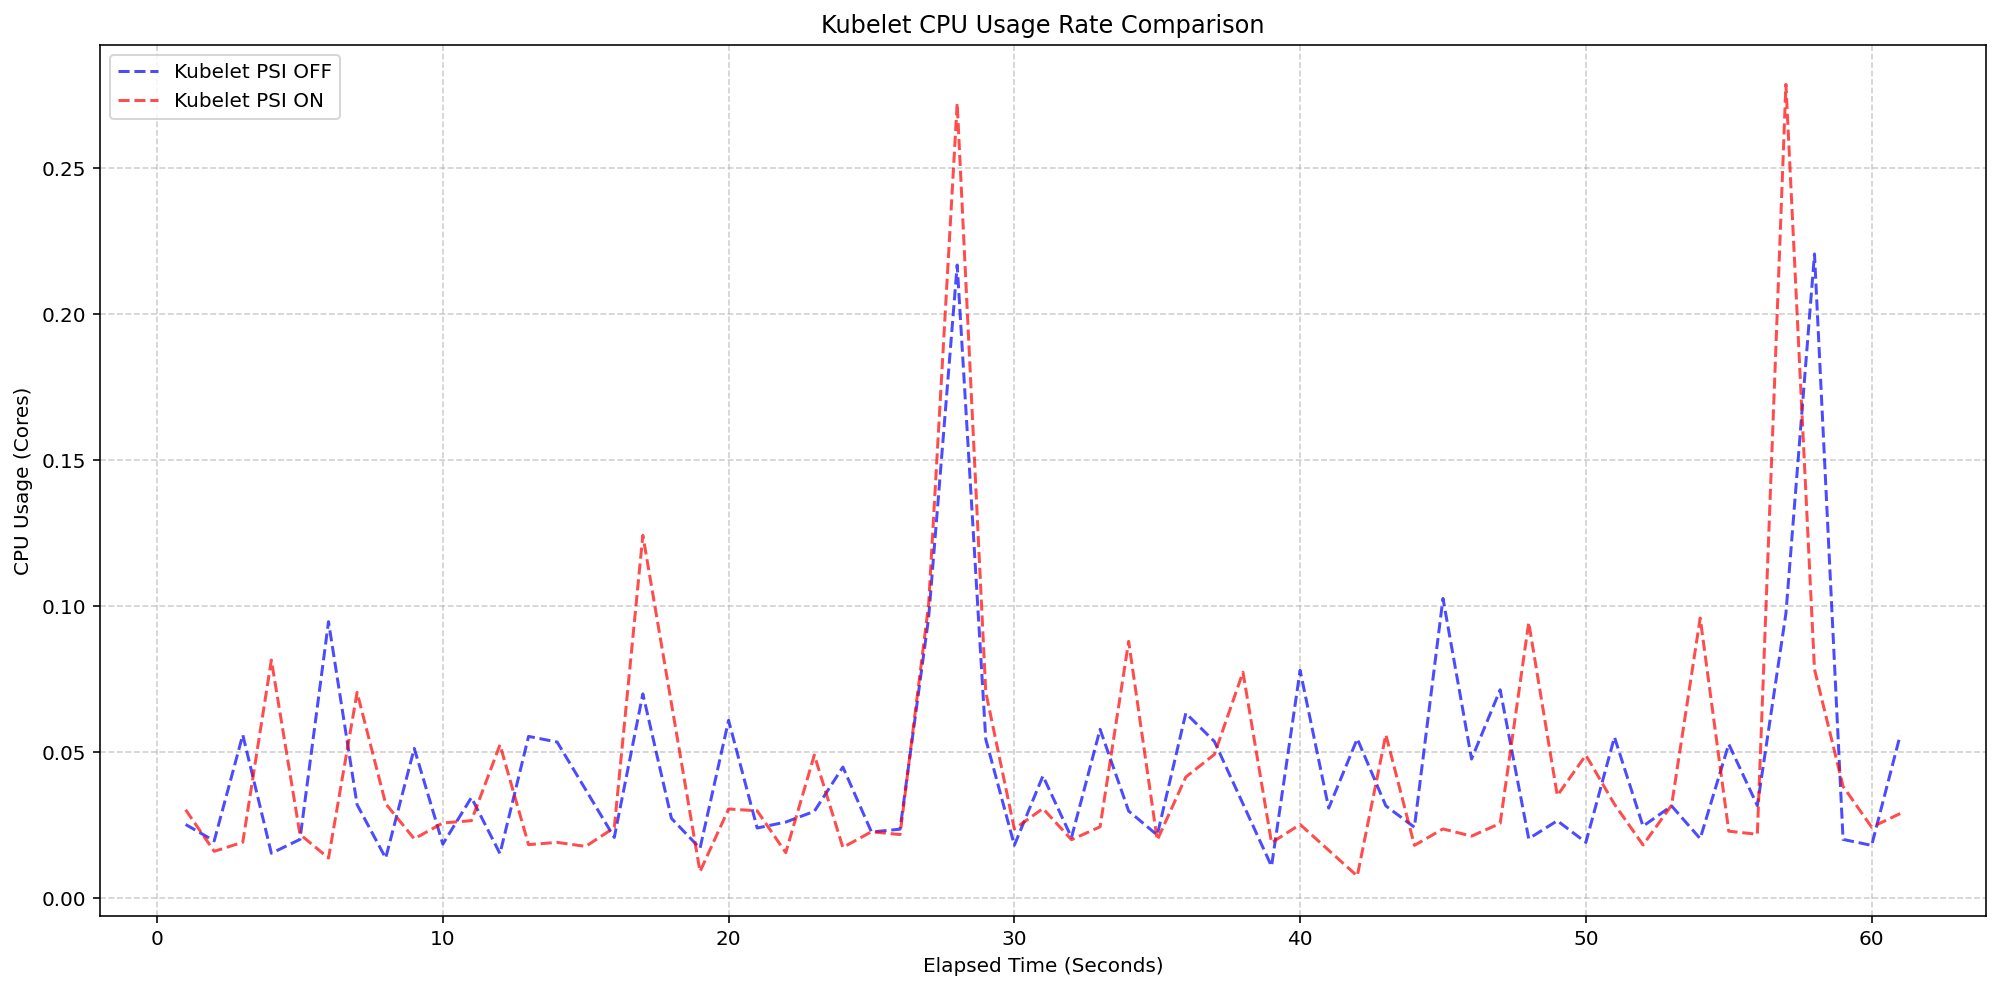
Figure 4 هم روی خود فرآیند kubelet zoom میکند؛ همان بخشی که collector اصلی این metricهاست. نتایج نشان میدهد که حتی وقتی kubelet بهصورت دورهای دادههای cgroup hierarchy را جمع میکند، مصرف CPU آن همچنان بسیار پایین میماند و spikeهای ثبتشده هم بهصورت کوتاه و قابلقبول هستند؛ بهطوریکه هیچکدام بیش از 0.25 core یا 6.25% از ظرفیت کل را برای بیشتر از یک ثانیه نگه نمیدارند.
(Case 2) Kubelet CPU Usage Rate Comparison
Figure 4: Kubelet CPU Usage Rate Comparison.
بهبودها بین beta (1.34) و stable (1.36)
Smartتر شدن emission metricها برای GA: در این نسخه، نحوه برخورد Kubelet با پشتیبانی OS از PSI بهتر شده است. قبلاً اگر قابلیت در Kubernetes فعال بود اما Linux kernel زیرساخت PSI را پشتیبانی نمیکرد (psi=0)، Kubelet metricهای صفر و گمراهکننده منتشر میکرد. این عددهای صفر میتوانستند در alerting بهاشتباه بهعنوان وضعیت واقعی تفسیر شوند و هشدارهای کاذب بسازند. در v1.36، Kubelet قبل از report کردن، پشتیبانی PSI در سطح OS را از طریق cgroup configuration تشخیص میدهد. نتیجه این است که pressure metricها فقط زمانی collect و emit میشوند که node واقعاً از آنها پشتیبانی کند؛ بنابراین دادهها برای monitoring و alerting تمیزتر و قابل اعتمادتر میشوند 📈
شروع کار
برای استفاده از PSI metrics در Kubernetes cluster، nodeهای شما باید این شرایط را داشته باشند:
اطمینان پیدا کنید که nodeها روی Linux kernel نسخه 4.20 یا جدیدتر اجرا میشوند و از cgroup v2 استفاده میکنند.
PSI باید در سطح OS فعال باشد؛ یعنی kernel با CONFIG_PSI=y کامپایل شده باشد و با پارامتر psi=0 بوت نشده باشد.
از v1.36 به بعد، Kubelet PSI metrics بهصورت generally available ارائه میشوند و دیگر نیازی به فعالسازی feature gate ندارید.
بعد از برآورده شدن پیشنیازهای OS، میتوانید endpoint مربوط به /metrics/cadvisor را با ابزار monitoring سازگار با Prometheus scrape کنید یا از Summary API برای جمعآوری و visualise کردن PSI metrics استفاده کنید. توجه داشته باشید که PSI یک قابلیت در Linux kernel است؛ بنابراین این metricها روی Windows nodeها در دسترس نیستند. البته cluster میتواند ترکیبی از Linux و Windows nodeها را داشته باشد و در Windows nodeها، Kubelet فقط PSI metricها را منتشر نمیکند.
اگر cluster شما از نسخههای جدید Kubernetes استفاده میکند و شما هم privileged node administrator هستید، میتوانید از طریق control plane API server به HTTP API مربوط به Kubelet proxy بزنید و دادههای فشار را بهصورت real-time از Summary API ببینید.
هشدار: proxy کردن به Kubelet یک عملیات privileged است. دادن دسترسی به آن ریسک امنیتی دارد، پس قبل از اجرای این دستورات مطمئن شوید مجوزهای administrative لازم را دارید.
CONTAINER_NAME=”example-container” kubectl get –raw “/api/v1/nodes/$(kubectl get nodes -o jsonpath='{.items[0].metadata.name}’)/proxy/stats/summary” | jq ‘.pods[].containers[] | select(.name==”‘”$CONTAINER_NAME”‘”) | {name, cpu: .cpu.psi, memory: .memory.psi, io: .io.psi}’
مطالعه بیشتر
اگر میخواهید دقیقتر با نحوه محاسبه و expose شدن این metricها آشنا شوید، این منابع مفید هستند:
مستندات رسمی Kernel
Understanding PSI در مستندات Kubernetes
cAdvisor Metrics Implementation
قدردانی
پشتیبانی از PSI metrics نتیجه همکاری تیمی SIG Node بوده است. تشکر ویژه از همه contributorهایی که در طراحی، پیادهسازی، تست، review و مستندسازی این قابلیت نقش داشتند؛ از مسیر alpha در v1.33، beta در v1.34 تا رسیدن به GA در v1.36 👏
برای ارسال بازخورد درباره این قابلیت، میتوانید به Kubernetes Node Special Interest Group بپیوندید، در گفتوگوهای کانال عمومی Slack با نام #sig-node شرکت کنید یا در GitHub issue ثبت کنید.
بازخورد
اگر تجربهای از استفاده این feature دارید و میخواهید آن را به اشتراک بگذارید، میتوانید در این مسیرها وارد گفتگو شوید:
SIG Node community page
Kubernetes Slack در کانال #sig-node
SIG Node mailing list
SIG Node دوست دارد تجربههای شما از استفاده این قابلیت در production را بشنود 💬




