





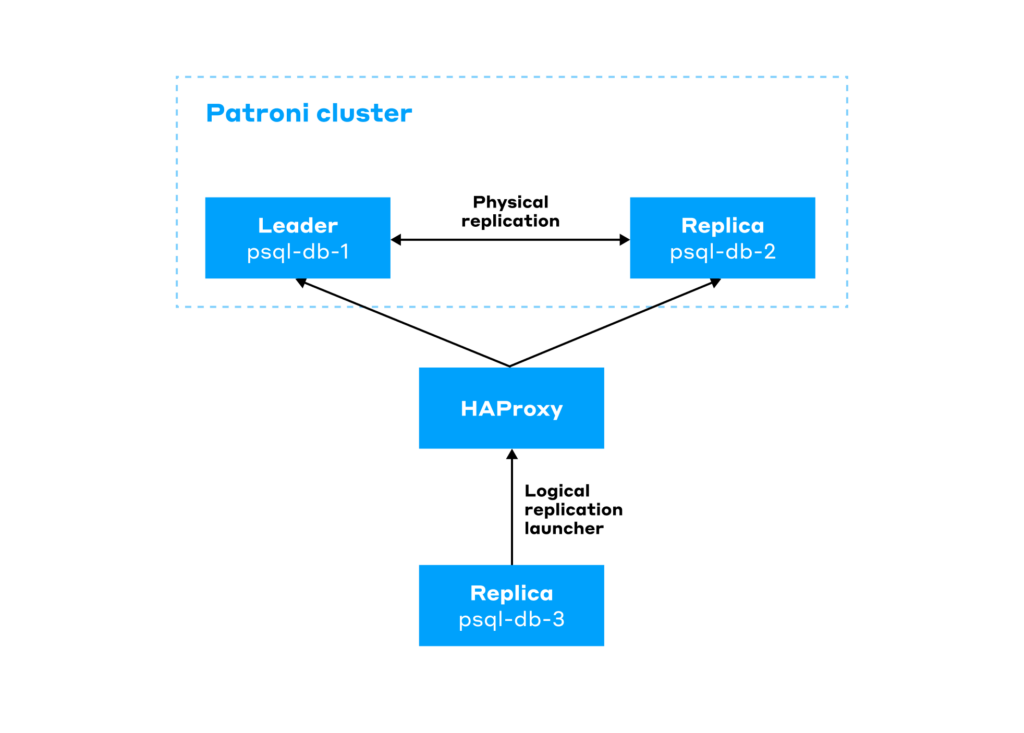
همه میدانند که failover در حالت asynchronous replication — چه با Patroni انجام شود و چه با هر ابزار دیگری — میتواند باعث از دست رفتن داده شود. این اتفاق معمولاً وقتی رخ میدهد که بعضی از transactionهایی که روی leader commit شدهاند، قبل از failover به replica نرسیده باشند. اما حتی اگر replica کاملاً با leader همگام باشد، باز هم در سناریوهایی که logical replication روی physical replication سوار شده، احتمال data loss وجود دارد. این مشکل را میشود در یک ساختار رایج PostgreSQL replication دید؛ مشابه همین سناریویی که اینجا داریم. 🙂
در این معماری، یک PostgreSQL cluster دو نودی داریم؛ psql-db-1 و psql-db-2 که بین آنها physical replication برقرار است و مدیریت خوشه هم با Patroni انجام میشود. بالای این دو نود، یک نود مستقل به نام psql-db-3 قرار دارد که تغییرات فقط یک table را از طریق logical replication دریافت میکند. برای اینکه psql-db-3 همیشه به leader فعلی Patroni وصل شود، ترافیک آن از طریق load balancer ای به نام HAProxy عبور میکند. HAProxy هم leader فعلی را با ارسال یک HTTP request به Patroni API تشخیص میدهد. خب، اینجا چه چیزی ممکن است خراب شود؟ 🤔
برای فهم بهتر، اول ببینیم Patroni با logical replication slotها چه میکند. از PostgreSQL 11 به بعد، Patroni میتواند از قابلیتی به نام permanent replication slots برای مدیریت logical replication slot استفاده کند. این موضوع در Dynamic Configuration Settings و PR اصلی هم توضیح داده شده است. اگر بخواهید Patroni بهصورت خودکار یک logical replication slot با LSN درست روی leader بسازد، کافی است این تنظیمات را به config Patroni اضافه کنید:
slots:
  permanent_logical_slot_name:
    type: logical
    database: db_name
    plugin: pgoutput
بعد از اضافه شدن این بخش، Patroni بهطور خودکار یک logical replication slot با نام permanent_logical_slot_name روی leader و با استفاده از pg_create_logical_replication_slot ایجاد میکند. علاوه بر این، همان replication slot را روی هر replicaای که در config Patroni با nofailover: false مشخص شده باشد هم میسازد. برای این کار، Patroni state مربوط به slot را از leader کپی میکند، فایل state داخل دایرکتوری pg_replslot را با pg_read_binary_file میخواند، همان فایلها را روی replicaها مینویسد و بعد PostgreSQL را روی آنها restart میکند.
وقتی slotها آماده شدند، Patroni هر loop_wait seconds، مقدار confirmed_flush_lsn را روی replicaها جلو میبرد. مقدار پیشفرض loop_wait برابر 10 ثانیه است و هم فاصله health checkها را مشخص میکند و هم بازه sync شدن با Distributed Configuration Store را. Patroni این مقدار را بر اساس دادههای DCS و با استفاده از تابع pg_replication_slot_advance تنظیم میکند. ⚙️
در نگاه اول ممکن است فکر کنید در زمان failover در Patroni، بدترین اتفاق برای یک logical replication slot این است که فقط بخشی از دادههای قبلاً ارسالشده دوباره برای logical replica فرستاده شود؛ آن هم به این دلیل که confirmed_flush_lsn در DCS کمی عقب افتاده است. اما ماجرا فقط این نیست. در محیط production، وقتی بین availability، data integrity و performance باید یکی را بیشتر فدا کنید، معمولاً availability قربانی میشود. یعنی برای بالا بردن performance، replication را asynchronous تنظیم میکنند و همین باعث میشود auto-failover واقعاً بتواند data loss ایجاد کند.
به همین خاطر، automatic failover غیرفعال است و اگر leader خوشه دیتابیس از کار بیفتد، یک کاربر تصمیم میگیرد که آیا switchover لازم است یا نه. اما چون automatic failover خاموش است، replicaها هم با برچسب nofailover: true مشخص شدهاند و Patroni روی آنها، logical slotهایی را که در بخش slots تعریف شدهاند، از قبل pre-create نمیکند. پس اگر یک managed failover انجام شود، leader قبلی در دسترس نباشد و logical replica هم در لحظه failover عقب افتاده باشد، چه اتفاقی میافتد؟ بیایید بررسی کنیم. 🧪
در وضعیت اولیه خوشهای که Patroni مدیریت میکند، psql-db-1 leader است:
patronictl list
+ Cluster: main (...)
--------+---------+-----------+----+-----------+------------------+
| Member | Host | Role | State | TL | Lag in MB | Tags |
+-----------+-----------------+---------+-----------+----+-----------+------------------+
| psql-db-1 | 192.168.100.101 | Leader | running | 38 | | clonefrom: true |
+-----------+-----------------+---------+-----------+----+-----------+------------------+
| psql-db-2 | 192.168.100.102 | Replica | streaming | 38 | 0 | clonefrom: true |
| | | | | | | nofailover: true |
+-----------+-----------------+---------+-----------+----+-----------+------------------+
حالا یک database آزمایشی به نام paydata بسازید، داخل آن یک table به نام payment ایجاد کنید، یک رکورد آزمایشی در آن درج کنید و این table را برای logical replication publish کنید:
CREATE DATABASE paydata;
c paydata
CREATE TABLE payment (
  id INTEGER PRIMARY KEY,
  customer INTEGER NOT NULL,
  merchant INTEGER NOT NULL,
  sum INTEGER NOT NULL
);
INSERT INTO payment (id, customer, merchant, sum) VALUES (1, 0, 1, 1000);
SELECT * FROM payment;
id | customer | merchant | sum
----+----------+----------+------
1 | 0 | 1 | 1000
CREATE PUBLICATION payment_pub FOR TABLE payment;
حالا روی سرور psql-db-3 یک database به نام test و یک table payment با ساختاری مشابه بسازید:
CREATE DATABASE test;
c test
CREATE TABLE payment (
  id INTEGER PRIMARY KEY,
  customer INTEGER NOT NULL,
  merchant INTEGER NOT NULL,
  sum INTEGER NOT NULL
);
بعد یک subscription بسازید که از طریق HAProxy به leader وصل شود:
test=# CREATE SUBSCRIPTION payment_sub CONNECTION 'dbname=paydata host=192.168.100.10 user=REPLICA_USER password=REPLICA_PASS' PUBLICATION payment_pub;
NOTICE: created replication slot "payment_sub" on publisher
Replication slot ساختهشده را هم به DCS مربوط به Patroni اضافه کنید:
slots:
  payment_sub:
    database: paydata
    plugin: pgoutput
    type: logical
حالا محتوای table payment را بررسی کنید:
test=# SELECT * FROM payment;
id | customer | merchant | sum
----+----------+----------+------
1 | 0 | 1 | 1000
(1 row)
طبق انتظار، داده از طریق physical replication slot به replica یعنی psql-db-2 هم رسیده است. حالا بیایید logical replica را عمداً عقب بیندازیم. برای این کار موقتاً PostgreSQL را روی psql-db-3 متوقف کنید:
pg_ctlcluster 16 main stop
بعد از آن، یک رکورد جدید به table test روی leader یعنی psql-db-1 اضافه کنید:
INSERT INTO payment (id, customer, merchant, sum) VALUES (2, 0, 1, 2000);
حالا کمی اوضاع را خراب کنیم. ارتباط شبکه را هم به PostgreSQL و هم به etcd روی leader یعنی psql-db-1 قطع کنید:
# Block incoming connections to PostgreSQL
iptables -A INPUT -p tcp --dport 5432 -j DROP

# Block incoming connections to Patroni from HAProxy
iptables -A INPUT -p tcp --dport 8008 -j DROP

# Block outbound traffic from Patroni to etcd
iptables -A OUTPUT -p tcp --dport 2379 -j REJECT
خوب شد؛ حالا خوشه leader خودش را از دست داده است:
psql-db-2 ~ # patronictl list
+ Cluster: main (...)
--------+---------+-----------+----+-----------+------------------+
| Member | Host | Role | State | TL | Lag in MB | Tags |
+-----------+-----------------+---------+-----------+----+-----------+------------------+
| psql-db-2 | 192.168.199.102 | Replica | streaming | 40 | 0 | clonefrom: true |
| | | | | | | nofailover: true |
+-----------+-----------------+---------+-----------+----+-----------+------------------+
فرض کنید در این لحظه یک on-call engineer وارد ماجرا شود، وضعیت را بررسی کند و به این نتیجه برسد که راهی برای بالا آوردن سریع leader قبلی وجود ندارد. برای شروع failover، او برچسب nofailover را از روی replica برمیدارد. Patroni هم failover را با موفقیت انجام میدهد:
psql-db-2 ~ # patronictl list
+ Cluster: main (...)
--------+--------+---------+----+-----------+-----------------+
| Member | Host | Role | State | TL | Lag in MB | Tags |
+-----------+-----------------+--------+---------+----+-----------+-----------------+
| psql-db-2 | 192.168.199.102 | Leader | running | 41 | | clonefrom: true |
+-----------+-----------------+--------+---------+----+-----------+-----------------+
و بهصورت خودکار یک replication slot هم روی psql-db-2 میسازد:
SELECT * FROM pg_replication_slots;
slot_name | plugin | slot_type | datoid | database | temporary | active | active_pid | xmin | catalog_xmin | restart_lsn | confirmed_flush_lsn | wal_status | safe_wal_size | two_phase | conflicting
-------------+----------+-----------+--------+------------+-----------+--------+------------+------+--------------+-------------+---------------------+------------+---------------+-----------+-------------
psql_db_1 | | physical | | | f | f | | | | D/F0030D45 | | reserved | | f |
payment_sub | pgoutput | logical | 178410 | paydata | f | f | | | 157213 | D/F0031E56 | D/F0033421 | reserved | | f | f
(2 rows)
از آنجا که replica psql-db-2 دقیقاً قبل از crash کاملاً همگام با leader بود، همه دادهها را دریافت کرده است. اینجا هیچ data lossی نداریم:
paydata=# SELECT * FROM payment;
id | customer | merchant | sum
----+----------+----------+------
1 | 0 | 1 | 1000
2 | 0 | 1 | 2000
(2 rows)
حالا logical replica روی psql-db-3 را دوباره بالا بیاوریم تا catch up کند:
pg_ctlcluster 16 main start
اینجا میبینیم که دادهای که در زمان crash روی psql-db-3 هنوز lag داشت، از دست رفته و هیچوقت هم به این replica نمیرسد:
test=# SELECT * FROM payment;
id | customer | merchant | sum
----+----------+----------+------
1 | 0 | 1 | 1000
(1 row)
متأسفانه این داده دیگر برنمیگردد! حالا یک رکورد دیگر روی leader جدید یعنی psql-db-2 اضافه کنیم:
INSERT INTO payment (id, customer, merchant, sum) VALUES (3, 0, 1, 3000);
وضعیت table روی leader اینطور است:
paydata=# SELECT * FROM payment;
id | customer | merchant | sum
----+----------+----------+------
1 | 0 | 1 | 1000
2 | 0 | 1 | 2000
3 | 0 | 1 | 3000
(3 rows)
و همان table روی logical replica اینطور دیده میشود:
test=# SELECT * FROM payment;
id | customer | merchant | sum
----+----------+----------+------
1 | 0 | 1 | 1000
3 | 0 | 1 | 3000
(2 rows)
این مثال خیلی واضح نشان میدهد که یک leader switchover دستی در خوشه Patroni میتواند روی یک logical replica که lag دارد باعث data loss شود، حتی اگر در خود cluster اصلی هیچ دادهای از بین نرفته باشد. اگر leader قبلی هنوز در دسترس بود، slot بدون مشکل کپی میشد. اما در این سناریو، Patroni فقط یک slot جدید روی leader جدید و با استفاده از current LSN ساخت. همینجا آن دادهای که روی logical replica جا مانده بود، برای همیشه از دست رفت. 🚨




