





به گزارش از وبسایت cncf
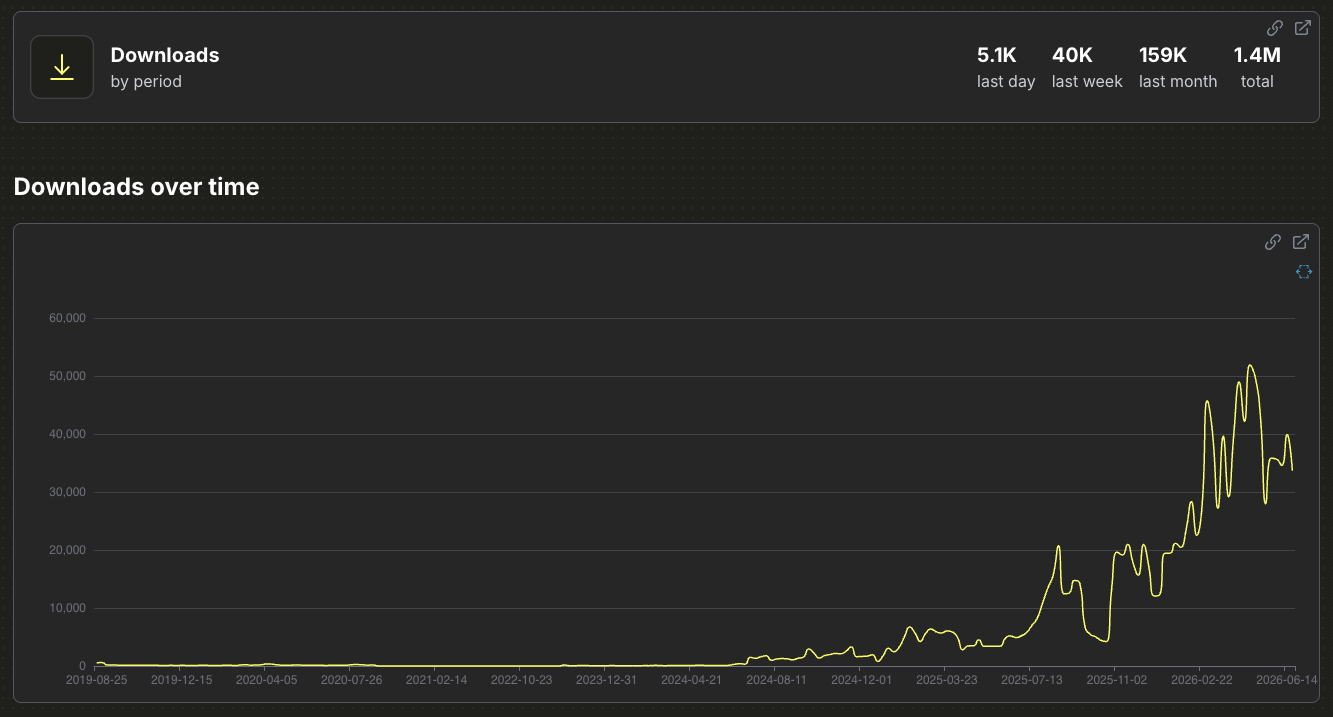
Kubeflow-sdk رسماً از مرز 1 میلیون دانلود در PyPI عبور کرده است — نشانهای از پذیرش سریع این رابط یکپارچه که کار با آموزش توزیعشده را ساده میکند. در این گزارش، این موفقیت را جشن میگیریم و اصول طراحی اصلی SDK و نحوهی تسهیل آموزش توزیعشده را مرور میکنیم. 🎉
پیشینه: اجرای بارهای کاری AI نباید نیازمند تخصص عمیق در سیستمهای توزیعشده یا هماهنگسازی کانتینر باشد. از نمونهسازی محلی روی لپتاپ تا استقرار روی یک خوشه Kubernetes، نیاز به یک API یکپارچه بود که پیچیدگی زیرساخت را پنهان کند و در عین حال انعطافپذیری را حفظ نماید. پیش از این، مسیر مهندسین ML به تولید در Kubeflow پراکنده و زمانبر بود: بازنویسی کد برای آموزش توزیعشده، بازسازی تصاویر کانتینر، نوشتن مانیفستهای Kubernetes YAML و کار با چندین API ناهمگون.
برای رفع این مشکلات، گروه کاری Kubeflow SDK & ML Experience شکل گرفت و با KEP-2170 طراحی Trainer را بازنگری کرد. نتیجه یک کلاینت پایتون محور بود که در نوامبر 2025 با دستور pip install kubeflow عرضه شد و شامل TrainerClient و OptimizerClient بهعنوان اولین مشتریهای یکپارچه بود. کمتر از یک سال پس از عرضه، بسته بیش از یک میلیون دانلود ثبت کرد.
با یک import kubeflow، کد پایتون تمیز به منابع Kubernetes مورد نیاز خوشه (مانند TrainJob، Experiment و سایر CRD) ترجمه میشود، بدون اینکه توسعهدهنده هرگز با مانیفستها سر و کار داشته باشد.
چه چیزی باعث موفقیت شده است: اصول طراحی SDK بر سه ستون اصلی استوار است:
1. سادگی پایتونیک: صفر YAML مورد نیاز — دانشمندان داده منابع را در پایتون پیکربندی میکنند، فراپارامترها را تعریف میکنند و آموزش توزیعشده را با APIهای بومی پایتون اجرا میکنند؛ بدون نوشتن مانیفست Kubernetes یا تنظیمات پیچیده YAML. 😊
2. قابلیت حمل multi-backend: یک API یکسان برای چند backend اجرا، که امکان انتقال بدون بازنویسی کد بین محیطهای محلی و تولید را فراهم میکند.
3. چرخه زندگی منسجم ML: تفکیک روشن بین نقشها — متخصصان ML میتوانند تمام کارها را در پایتون انجام دهند و تیمهای پلتفرم میتوانند ماژولهای مشتری سازمانی را برای مدیریت چرخه زندگی کامل مدلها استفاده کنند.
قابلیت حمل — سه بکاند معمول و کاربرد هر یک:
Local Process — سریعترین تکرار برای توسعه محلی؛ اجرای آموزشی بهعنوان یک زیرفرآیند پایتون با سربار زیرساخت صفر.
Container — مشابه محیط لپتاپ با محیطهای Docker/Podman برای تطبیق بهتر با Production.
Kubernetes — مقیاس تولید: اجرای TrainJob توزیعشده با تحمل خطا و زمانبندی منابع. تعویض بین این حالتها معمولاً با یک تغییر پیکربندی یکخطی انجام میشود و کد آموزشی نیازی به تغییر ندارد.
ادغام اکوسیستم — وضعیت کنونی برخی زیرپروژهها بهصورت خلاصه: ✅ Trainer: آموزش مدل توزیعشده و موتور fine-tuning در دسترس است. ✅ Katib: تنظیم خودکار هایپرپارامترها در دسترس. ✅ Model Registry: ردیابی متمرکز نسخهها و مصنوعات در دسترس. اجرای بومی orchestration برای مدیریت workflowهای ML نیز فراهم شده است.
بهعنوان نمونه، اجرای توزیعشده PyTorch با چند خط کد پیچیدگیهای تنظیم دستی متغیرهایی مثل MASTER_ADDR یا WORLD_SIZE را پنهان میکند. مثال کد نمونه به شکل زیر است:
from kubeflow.trainer import TrainerClient, CustomTrainer
import torch
import torch.nn as nn

def train_model():
    model = nn.Linear(10, 1)
    # training loop here
    print("Training work full!")

client = TrainerClient()
job_name = client.train(
    trainer=CustomTrainer(func=train_model, num_nodes=2, resources={"cpu": "2", "memory": "4Gi"})
)
print(f"Distributed training job '{job_name}' is running on Kubernetes.")
در پشت صحنه، SDK تابع آموزشی و وابستگیهای آن را سریالی میکند، بهصورت پویا یک TrainJob CRD تولید میکند و آن را به اپراتور آموزشی ارسال مینماید — یعنی تخصص YAML و Kubernetes در یک فایل پایتون خلاصه میشود.
مثالهای بیشتر: ماژولهای مشتری دیگر شامل SparkClient برای پیشپردازش داده در مقیاس بزرگ، TrainerClient برای آموزش در PyTorch، DeepSpeed و TensorFlow، OptimizerClient برای اجرای آزمایشهای Katib بدون نوشتن YAML و PipelinesClient برای هماهنگسازی کامل زنجیره پیشپردازش تا آموزش و تنظیم در KFP هستند. برای نمونهها به صفحه رسمی Kubeflow SDK مراجعه کنید.
نظرسنجی کاربران نشان داد که سه اولویت اصلی جامعه عبارتند از: 1) پیکربندی زیرساخت سادهتر، 2) اشکالزدایی بهتر با گزارشها و ردیابی توزیعشده، و 3) تسریع در گردش کار تکراری محلی قبل از انتقال به ابر. این بینشها نقشه راه 2026 را شکل میدهند. 📊
نگاه به آینده — اولویتهای کلیدی نقشه راه 2026 عبارتند از: ارائه Kubeflow SDK بهعنوان ابزارهای قابل فراخوانی با استفاده از پروتکل Model Mesh (MCP SDK)، ادغام OpenTelemetry برای مشاهده و ردیابی ساختارمند و توسعه یک Dynamic LLM Trainer برای تنظیم دقیق مدلهای زبان بزرگ از جمله پشتیبانی GPU و چکپوینتهای شفاف GPU برای مشاغل طولانیمدت. 🚀
به انجمن بپیوندید! مشارکت، بازخورد و کمک شما مورد استقبال است. راههای ارتباطی: پیوستن به #kubeflow-ml-experience در CNCF Slack، شروع با راهنمای Quickstart برای آموزش اولین مدل با Kubeflow SDK، و مراجعه به منابع زیر:
Github: https://github.com/kubeflow/sdk
مستندات: https://www.kubeflow.org/docs/components/sdk/
از مشارکتکنندگان سپاسگزاریم — همکاری شما موجب رشد اکوسیستم میشود! 🙏




