





در ۲۱ اوت ۲۰۲۶، Severin Neumann از Causely در این مطلب که پروژههای CNCF را برجسته میکند، توضیح میدهد که کوئریهای کند SQL میتوانند تجربه کاربر را تضعیف کنند، باعث زنجیرهای از خطاها شوند و عملیاتهای ساده را به incidentهای production تبدیل کنند. راهحل سنتی چیست؟ جمعآوری telemetry بیشتر. اما telemetry بیشتر لزوماً به معنای درک بهتر نیست؛ فقط چیزهای بیشتری برای بررسی ایجاد میکند. به جای آنکه traces را صرفاً یک جریان داده بدانیم که شاید روزی تحلیلش کنیم، باید در لحظه تصمیمگیری روی چیزهایی تمرکز کنیم که واقعاً اهمیت دارند.
همانطور که در The Signal in the Storm گفتیم، telemetry خام فقط زمانی مفید میشود که الگوهای معنادار را از آن استخراج کنیم. در این راهنما، یک workflow تکرارپذیر میسازید که spanهای پایگاه داده در OpenTelemetry را به metrics مشتقشده از span تبدیل میکند؛ metricهایی که میتوانید برای dashboard و alert از آنها استفاده کنید. به این ترتیب میتوانید تشخیص دهید چه چیزی کند است، چه چیزی بیشترین اهمیت را دارد و چه چیزی فقط دچار regression شده است. 😊
برای ملموستر شدن موضوع، این راهنما با کوئریهای کند SQL دو سناریو را پوشش میدهد: Optimization: کدام queryها اگر سریعتر شوند، با توجه به میزان traffic بیشترین ارزش را ایجاد میکنند؟ Incident response: کدام queryها همین حالا رفتار غیرعادی دارند؟
در اینجا یک lab میسازیم که در آن اپلیکیشن شما traces مربوط به OpenTelemetry را تولید میکند و ما آنها را به metrics قابل اقدام تبدیل میکنیم؛ ابتدا با تشخیص سادهی کوئری کند، سپس با درنظرگرفتن impact بر اساس traffic، و در نهایت با anomaly detection. اگر میخواهید از بخشهای نظری عبور کنید، میتوانید مستقیم به بخش Lab Setup در پایین بروید؛ اما دانستن زمینه، درک آنچه میسازید را سادهتر میکند.
[Embedded video: “The Signal in the Storm: Practical Strategies for Managing Telemetry Overload” — Endre Sara]
What Makes a Query Slow?
«کند بودن» یک مشکل واحد نیست؛ بلکه نشانهای است با علتهای کاملاً متفاوت. یک query با زمان ۵۰ms ممکن است برای یک داشبورد گزارشگیری مناسب باشد، اما برای checkout فاجعهبار است. همانطور که در High Performance MySQL تأکید شده، اینکه چرا یک query کند است، تعیین میکند چگونه باید آن را اصلاح کرد.
رایجترین عواملی که میتوانند باعث کند شدن queryها شوند عبارتاند از:
Excessive Work
پایگاه داده کار بیشتری از نیاز انجام میدهد؛ معمولاً بهدلیل full table scan ناشی از نبود index یا نامعتبر بودن آن. اگر روی customer_id ایندکسی وجود نداشته باشد، یک SELECT ساده مثل SELECT * FROM orders WHERE customer_id = $1 از ۲۰ms در ۱۰ هزار ردیف به چند دقیقه در ۱۰ میلیون ردیف میرسد. خود query تغییر نکرده، اما حجم داده تغییر کرده است. برای مبانی این موضوع، Use The Index, Luke! را ببینید.
Aggregationها و joinها این وضعیت را شدیدتر میکنند. حتی queryهای دارای index هم ممکن است زمانی که planner در برآورد cardinality اشتباه کند و strategy نادرستی برای join انتخاب کند، بهشدت کند شوند.
Resource Contention
حتی queryهای کاملاً بهینه هم وقتی منتظر منابع بمانند کند میشوند. lock contention باعث میشود queryها تا زمان آزاد شدن rowها توسط transactionهای دیگر متوقف شوند. Connection pool exhaustion هم پیش از شروع اجرای query، latency اضافه میکند. اگر یک query، ۹۵٪ زمان خود را صرف انتظار برای lock کند، با query optimization حل نمیشود و به redesign transaction نیاز دارد.
Environmental Pressure
اشباع CPU، گلوگاههای I/O و فشار حافظه میتوانند هر query را کند کنند. همان SQL با همان plan، در شرایط resource contention عملکردی کاملاً متفاوت خواهد داشت.
Plan Regressions
وقتی execution planها تغییر میکنند، performance افت میکند؛ حتی اگر query و دادهها همان باشند. parameter-sensitive planها برای یک مجموعه از مقادیر بهینهاند اما برای مقادیر دیگر شکست میخورند. همچنین statistics قدیمی پس از bulk load باعث میشوند planner strategyهای بسیار بدی انتخاب کند. مستندات PostgreSQL Performance Tips توضیح میدهد چگونه این regressionها را شناسایی کنید.
Pathological Patterns
بعضی از کندیها در slow query logها دیده نمیشوند. مشکل N+1، صد query سریعِ ۲ms را بهصورت sequential اجرا میکند و در مجموع ۲۰۰ms latency بهعلاوه overhead شبکه ایجاد میکند. هیچ queryای بهتنهایی «کند» نیست، اما الگوی کلی فاجعهبار است.
The Classic Workflow: DB-Native Tooling + Manual Triage
پایگاههای داده ابزارهای تشخیصی بسیار خوبی دارند: slow query logها، query storeهایی مثل pg_stat_statements در PostgreSQL، و بررسی plan با EXPLAIN. این ابزارها نشان میدهند چه چیزی داخل database پرهزینه است. اما چیزی که ارائه نمیدهند context است. کدام service این query کند را اجرا کرده؟ آیا user-facing است یا background job؟ آیا با latency spikeای که بررسی میکنید ارتباط دارد؟
در نهایت، شما فقط فهرستی از queryهای کند دارید و هیچ سیگنالی درباره اینکه کدامیک مهمتر است، در اختیار ندارید. معمولاً یک نفر این شکاف را بهصورت دستی پر میکند: یک developer یک endpoint کند را میبیند، query را به DBA میدهد و آنها با هم آن را بهینه میکنند. این روش جواب میدهد، اما همین اتصال دستی دقیقاً همان چیزی است که میتوانیم خودکار کنیم. 🙂
Bringing Context to Slow Queries
ابزارهای database به شما میگویند چه چیزی کند است، اما نه اینکه چرا اهمیت دارد. وقتی یک query کند را در logها پیدا میکنید، context حیاتی را از دست دادهاید: کدام service آن را اجرا کرده؟ آیا مربوط به کاربر است یا پردازش پسزمینه؟ آیا با latency spike مورد بررسی شما همزمان شده است؟
Distributed traceها این context را فراهم میکنند. هر database span در context یک request قرار دارد و میداند کدام service، endpoint و کاربر آن را فعال کرده است. بهجای آنکه بعداً database logها و traceها را به هم مرتبط کنیم، slow queryها را مستقیماً از traceها تحلیل میکنیم؛ در حالی که همه contextهای application از قبل همراه آنهاست.
The Building Blocks
حالا که فلسفه کار و ارزش traceهای غنی از context را میدانیم، بیایید به building blockهایی نگاه کنیم که برای پیادهسازی slow query analysis استفاده خواهیم کرد.
The Observability Stack
برای این lab از OpenTelemetry Collector بههمراه docker-otel-lgtm استفاده میکنیم؛ یک stack آماده از Grafana که Loki، Grafana، Tempo و Mimir را در یک container واحد بستهبندی میکند. این ترکیب، یک محیط observability کامل را با حداقل setup در اختیار ما میگذارد.
The Application
اپلیکیشن نمونهی ما یک “Album API” ساده مبتنی بر Go است که دادههای album موسیقی را از PostgreSQL ارائه میدهد. این برنامه عمداً طوری طراحی شده که همان نوع queryهای کند و intermittent را تولید کند که در production رایج هستند. سرویسها از otelsql برای instrument کردن database callها استفاده میکنند و spanهایی با stable OpenTelemetry database semantic conventions تولید میکنند.
The Dashboards
ما سه dashboard میسازیم که هر کدام یک لایه insight اضافه میکنند:
یک نمای ساده از queryها بر اساس duration
Queryهایی که با traffic وزندهی شدهاند تا فرصتهای optimization مشخص شوند
Anomaly detection برای شناسایی queryهایی که از رفتار معمول خود منحرف شدهاند
Lab Setup
بیایید theory را به عمل تبدیل کنیم. یک sample application clone میکنیم، observability stack را اجرا میکنیم و سه رویکرد تدریجی برای تحلیل slow queryها را بررسی میکنیم. تنها چیزی که نیاز دارید Docker نصبشده است.
Clone and Run
git clone https://github.com/causely-oss/slow-query-lab
cd slow-query-lab
docker-compose up -d
پس از اجرا، Grafana را در http://localhost:3001 باز کنید؛ جایی که dashboardهای خود را بررسی خواهیم کرد. 🚀
Queries by Duration
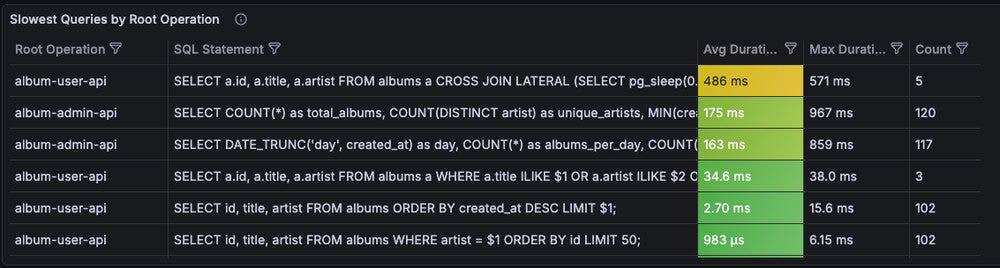
اولین dashboard مستقیمترین رویکرد را دنبال میکند: از Tempo برای database spanها query میگیرد و آنها را aggregate میکند تا queryهایی که بیشترین زمان را میبرند پیدا شوند. این همان چیزی است که احتمالاً در شروع بررسی traceها برای تحلیل slow query میسازید.
What It Shows
داشبورد Slow SQL – By Duration مستقیماً با استفاده از TraceQL این query را اجرا میکند:
<br>{ span.db.system != "" } | select(span.db.query.text, span.db.statement)<br>
این query همه spanهایی را پیدا میکند که attributeهای database دارند و سپس با استفاده از Grafana transformations این کارها را انجام میدهد:
Group by root operation (API endpoint) و SQL statement
Aggregate duration به صورت mean، max و count
Sort بر اساس میانگین duration از کندترین به سریعترین
نتیجه یک جدول است که کندترین queryها، endpointهایی که آنها را فعال کردهاند، و تعداد دفعات وقوعشان را نشان میدهد.
[Image: Slowest queries by root operation]
What’s Good About This
این روش فوراً visibility لازم را نسبت به queryهای دارای context کامل application فراهم میکند:
میتوانید دقیقاً ببینید کدام SQL statementها بیشترین زمان را میگیرند
میدانید کدام API endpointها آنها را فعال میکنند
با count میتوانید frequency را بفهمید
میتوانید برای debugging به traceهای تکی drill down کنید
این یک بهبود اولیه نسبت به raw database logهاست، چون از همین ابتدا context application را میبینید؛ contextی که slow queryها را قابل اقدام میکند.
The Limitation
مشکل اینجاست که مرتبسازی بر اساس میانگین duration به شما نمیگوید کدام queryها واقعاً مهمترند. دو query زیر را در نظر بگیرید:
Query
Avg Duration
Count
Complex report
2.3s
5
Search
150ms
10,000
query مربوط به گزارش پیچیده از نظر میانگین duration کندتر است، پس در بالا نمایش داده میشود. اما query جستوجو، با وجود آنکه بهطور میانگین سریعتر است، ۲۰۰۰ برابر بیشتر اجرا میشود. impact کلی آن روی کاربران بسیار بیشتر است.
این dashboard فقط میگوید چه چیزی کند است، نه چه چیزی impactful است. برای این کار باید حجم traffic را هم در نظر بگیریم.
Traffic-Weighted Impact Analysis
داشبورد دوم این محدودیت را با معرفی یک impact score برطرف میکند: حاصلضرب میانگین duration در تعداد callها.
What It Shows
داشبورد Slow SQL – Traffic Weighted از همان TraceQL query استفاده میکند، اما یک field محاسبهشده اضافه میکند:
<br>Impact = Avg Duration × Count<br>
این فرمول ساده یک insight مهم را ثبت میکند: یک query با کندی متوسط که هزاران بار اجرا میشود، impact کلی بیشتری از یک query بسیار کند اما کمتکرار دارد. داشبورد بر اساس impact score مرتب میشود و queryهایی را بالا میآورد که برای کاربران شما مهمترند.
این dashboard همچنین موارد زیر را اضافه میکند:
Service breakdown: ببینید کدام service هر query را فعال کرده است
Latency distribution: duration را در طول زمان ببینید، نه فقط میانگین را
Top queries by impact: نمایی سریع برای اینکه بدانید روی کجا تمرکز کنید
[Image: Highest impact queries by root operation]
What’s Good About This
impact وزندهیشده بر اساس traffic، سیگنال بسیار بهتری برای اولویتبندی کارهای optimization به شما میدهد:
queryهای پرترافیک و نسبتاً کند بالاتر از queryهای نادر اما بسیار کند قرار میگیرند
میتوانید با اعداد واقعی impact، ضرورت optimization را توضیح دهید
context مربوط به service و endpoint کمک میکند مسئله را به تیم درست ارجاع دهید
وقتی کسی بپرسد «اول کدام queryهای کند را باید optimize کنیم؟»، این dashboard پاسخ قابل دفاعی ارائه میدهد. این دقیقاً همان چیزی است که برای برنامهریزی بهبود performance نیاز دارید.
The Limitation
اما این dashboard برای optimization است، نه incident response. حتی با impact وزندهیشده بر اساس traffic هم یک سؤال حیاتی را پاسخ نمیدهد: «چه چیزی تغییر کرده است؟»
فرض کنید query جستوجوی شما امتیاز impact برابر ۱۵۰٬۰۰۰ دارد. آیا این طبیعی است؟ آیا از دیروز بیشتر شده؟ از هفته قبل چطور؟ این dashboard وضعیت فعلی را بهصورت یک snapshot نشان میدهد، اما هیچ مفهومی از baseline ندارد.
این موضوع هنگام incidentها بسیار مهم است. وقتی latency افزایش پیدا میکند، فقط نمیخواهید بدانید «queryهای جستوجو کند هستند»؛ میخواهید بدانید «queryهای جستوجو از حالت عادی کندتر شدهاند».
باید بین این موارد تمایز قائل شوید: A




